Un martes a las once llega un correo: «no podemos entrar». ¿Es un cliente que ha olvidado la contraseña o es que el inicio de sesión está caído para todos? La diferencia entre las dos cosas es la diferencia entre una respuesta en la cola y despertar al equipo de desarrollo.
Sin reglas, esa decisión depende de quién lee el correo y de cómo de nervioso esté. Una matriz de escalado la deja tomada de antemano.
La respuesta corta
Una matriz de escalado de incidencias es una tabla que, para cada nivel de gravedad, dice cómo reconocerlo, quién se encarga, en cuánto tiempo hay que responder y a quién se avisa si no se resuelve. En un SaaS bastan cuatro niveles: crítica (el servicio no funciona para muchos clientes), alta (una función importante falla o un cliente grande está bloqueado), media (algo falla pero hay alternativa) y baja (dudas, errores menores, peticiones). La clave está en definir cada nivel con ejemplos de tu producto, no con adjetivos, y en que el primer contacto (una persona o un agente de IA) sepa clasificar y pasar el caso con el contexto.
La plantilla
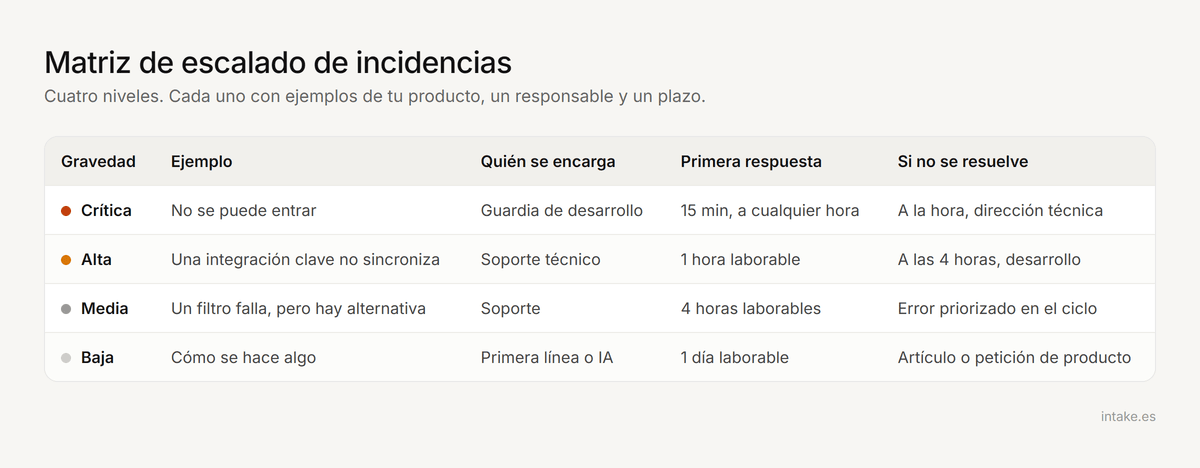
| Gravedad | Cómo reconocerla | Ejemplos en un SaaS | Quién se encarga | Primera respuesta | Si no se resuelve |
|---|---|---|---|---|---|
| Crítica | Afecta a muchos clientes o a datos | No se puede entrar, la aplicación no carga, pérdida o fuga de datos, cobros duplicados masivos | Guardia de desarrollo + responsable de soporte | 15 minutos, a cualquier hora | A la hora, dirección técnica; aviso en la página de estado |
| Alta | Una función clave falla o un cliente grande está bloqueado | No se exportan informes, una integración principal no sincroniza, un cliente enterprise no puede trabajar | Soporte técnico (nivel 2) | 1 hora en horario laboral | A las 4 horas, desarrollo |
| Media | Algo falla, pero hay alternativa | Un filtro no funciona, un correo de aviso no llega, un error en un navegador concreto | Soporte (nivel 1 o 2) | 4 horas laborables | Se registra como error y se prioriza en el siguiente ciclo |
| Baja | Dudas, errores visuales, peticiones | Cómo se hace algo, un texto mal traducido, una función que el cliente echa en falta | Primera línea o agente de IA | 1 día laborable | Se convierte en artículo o en petición de producto |
Los plazos son un punto de partida para un SaaS pequeño: ajústalos a lo que puedas cumplir y, si vendes a empresas, a lo que hayas firmado. Cómo poner plazos razonables, en qué es un SLA.
Cómo clasificar sin dudar
Tres preguntas, en este orden:
- ¿A cuántos clientes afecta? Si son muchos o no lo sabes todavía, empieza por crítica y baja después.
- ¿Puede seguir trabajando? Si hay una alternativa, es media como mucho.
- ¿Hay datos o dinero en juego? Fuga de datos, pérdida de información o cobros erróneos suben siempre un nivel.
Ante la duda, sube. Bajar la gravedad de un caso que resultó menor no cuesta nada; tratar como baja una caída general cuesta clientes.
Quién hace qué
- Primera línea (persona o agente de IA): recoge lo necesario (qué hacía, desde cuándo, a quién afecta, captura del error), clasifica y pasa.
- Soporte técnico: reproduce el problema, busca si hay más casos y decide si es un error.
- Desarrollo: lo arregla. En crítica, hay alguien de guardia.
- Responsable de soporte: comunica a los clientes afectados y decide cuándo se cierra.
Cómo se reparten los niveles, en niveles de soporte técnico. Y cómo recoger un error para que desarrollo pueda reproducirlo a la primera, en reportes de bugs de clientes.
Con un equipo de tres personas
La matriz no necesita un organigrama. En una startup:
- Crítica: el fundador técnico tiene el móvil encendido. Punto.
- Alta: la persona de soporte avisa por el canal del equipo y alguien de desarrollo lo coge ese día.
- Media y baja: se quedan en la bandeja y se revisan en la reunión semanal.
Lo que no puede faltar, aunque seáis tres: los ejemplos de cada nivel escritos y un sitio donde se vea qué casos están en cada nivel.
Comunicar mientras dura
Una incidencia crítica es también un problema de comunicación: los clientes quieren saber que lo sabéis. Publica en la página de estado en los primeros minutos, actualiza aunque no haya novedades y explica qué pasó al cerrar. Qué decir, en cómo comunicar una incidencia sin perder al cliente.
El papel del agente de IA
Un agente de IA en primera línea ayuda en dos cosas: resuelve lo de gravedad baja (dudas de uso) y, en lo demás, recoge los datos antes de pasar el caso. Lo que no debe hacer es decidir solo que algo no es grave: si varios clientes reportan lo mismo en poco tiempo, eso tiene que llegar a una persona.
Cómo lo hace Intake
En Intake, el agente de IA responde las dudas con tu documentación y, cuando el caso necesita a alguien, pide antes los detalles que faltan y pasa la conversación al equipo que toque con el historial y lo que ya se intentó. Las reglas de escalado deciden a qué equipo va según el canal, si el cliente está identificado o el dominio de su correo, y en las instrucciones del agente puedes escribir tu propia matriz para que la aplique. Lo tienes en escalado a una persona y en derivar con contexto.
Preguntas frecuentes
¿Qué es una matriz de escalado de incidencias?
Una tabla que define, para cada nivel de gravedad, cómo reconocerlo, quién se encarga, el plazo de respuesta y a quién se avisa si no se resuelve.
¿Cuántos niveles de gravedad hacen falta?
Cuatro bastan en un SaaS: crítica, alta, media y baja. Más niveles complican la clasificación sin mejorar la respuesta.
¿Qué plazos pongo en cada nivel?
Los que puedas cumplir. Como punto de partida: 15 minutos para crítica, 1 hora para alta, 4 horas laborables para media y 1 día laborable para baja.
¿Quién decide la gravedad de una incidencia?
La primera línea la propone con tres preguntas (a cuántos afecta, si hay alternativa, si hay datos o dinero en juego) y soporte técnico la confirma.
¿Puede un agente de IA escalar incidencias?
Puede recoger los datos y pasar el caso al equipo adecuado. Lo que no debe es decidir solo que algo no es grave.